| |
| import pandas as pd |
| |
| import numpy as np |
| |
| |
| |
| |
| from sklearn.model_selection import train_test_split |
| |
| from sklearn.tree import DecisionTreeClassifier |
| |
| |
| from sklearn.metrics import accuracy_score |
| |
| |
| from sklearn import tree |
| from IPython.display import Image |
| import pydotplus |
| |
| tennis_data = pd.read_csv('/content/drive/MyDrive/Colab Notebooks/playtennis.csv') |
| tennis_data |
셀 실행 결과 tennis_data의 데이터를 확인할 수 있다.

| tennis_data.Outlook = tennis_data.Outlook.replace('Sunny', 0) |
| tennis_data.Outlook = tennis_data.Outlook.replace('Overcast', 2) |
| tennis_data.Outlook = tennis_data.Outlook.replace('Rain', 1) |
| |
| tennis_data.Temperature = tennis_data.Temperature.replace('Hot', 1) |
| tennis_data.Temperature = tennis_data.Temperature.replace('Mild', 2) |
| tennis_data.Temperature = tennis_data.Temperature.replace('Cool', 3) |
| |
| tennis_data.Humidity = tennis_data.Humidity.replace('High', 1) |
| tennis_data.Humidity = tennis_data.Humidity.replace('Normal', 2) |
| |
| tennis_data.Wind = tennis_data.Wind.replace('Weak', 1) |
| tennis_data.Wind = tennis_data.Wind.replace('Strong', 2) |
| |
| tennis_data.PlayTennis = tennis_data.PlayTennis.replace('No', 1) |
| tennis_data.PlayTennis = tennis_data.PlayTennis.replace('Yes', 2) |
| |
| tennis_data |
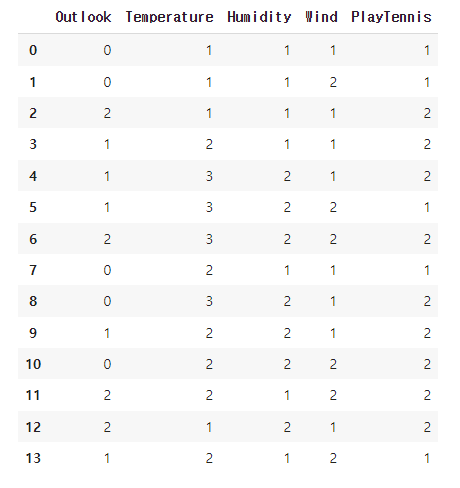
모델을 학습시킬 때는 모든 데이터를 숫자로 변환하여 학습 시켜야한다. 아래는 데이터를 모두 수치화 시킨 tennis_data이다.
| X = np.array(pd.DataFrame(tennis_data, columns=['Outlook', 'Temperature', 'Humidity', 'Wind'])) |
| |
| Y = np.array(pd.DataFrame(tennis_data, columns=['PlayTennis'])) |
tennis_data를 독립 변수(기준)과 종속 변수(결과)로 분리해준다.
x_train, x_test, y_train, y_test = train_test_split(X, Y)
X, y를 훈련데이터와 테스트 데이터로 분리해준다.
| dt_clf = DecisionTreeClassifier() |
| dt_clf = dt_clf.fit(x_train, y_train) |
지도학습 분류 알고리즘이라는 거창한 이름에 걸맞지 않긴 하지만 위의 두 줄로 학습은 완료된다.
df_clf라는 변수에 Decision Tree를 생성 해준 뒤 fit함수를 이용하여 생성된 트리를 훈련데이터에 맞춰준다.
dt_prediction = dt_clf.predict(x_test)
predict함수를 이용하여 테스트 데이터에 대한 결과를 계산해준다.
| accuracy = accuracy_score(y_test, dt_prediction) |
| print(f'정확도:{accuracy}') |
이 때, 출력되는 정확도의 경우에는 tain_test_split 이하의 셀들을 반복할 때마다 바뀐다. 그렇기 때문에 정확도가 0 또는 0.25와 같이 매우 낮은값이 나와도 잘못한 것이 아니니 너무 신경쓰지는 말길 바란다.
| feature_names = tennis_data.columns.tolist() |
| feature_names = feature_names[0:4] |
| |
| target_name = np.array(['Play No', 'Play Yes']) |
| |
| dt_dot_data = tree.export_graphviz(dt_clf, out_file=None, |
| feature_names=feature_names, |
| class_names=target_name, |
| filled=True, rounded=True, |
| special_characters=True) |
| |
| dt_graph = pydotplus.graph_from_dot_data(dt_dot_data) |
| Image(dt_graph.create_png()) |
학습된 Decision Tree를 도식화해서 출력해주는 코드이다. 이것 역시 재실행할 때 마다 바뀐다.
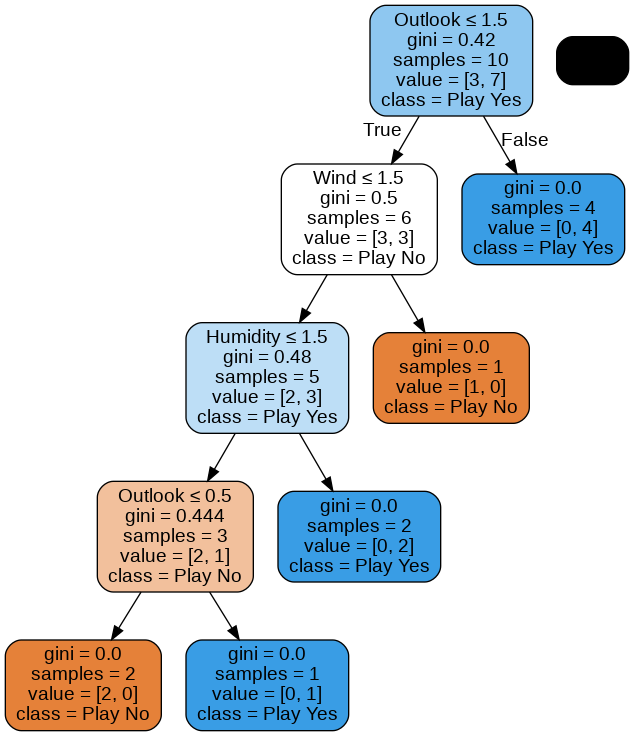 훈련 결과